Setup
!pip install nucleus-cdk==0.5.0rc2 | tail -n2

# Surface a failed install here, rather than as a confusing ModuleNotFoundError
# in the import cell below.
import importlib.metadata as md
assert md.version("nucleus-cdk") == "0.5.0rc2", f"got {md.version('nucleus-cdk')}"
Requirement already satisfied: urllib3<3,>=1.21.1 in /opt/homebrew/Caskroom/miniforge/base/lib/python3.12/site-packages (from requests->panel>=1.0->hvplot<0.12.0,>=0.11.1->nucleus-cdk==0.5.0rc2) (2.5.0)
Requirement already satisfied: certifi>=2017.4.17 in /opt/homebrew/Caskroom/miniforge/base/lib/python3.12/site-packages (from requests->panel>=1.0->hvplot<0.12.0,>=0.11.1->nucleus-cdk==0.5.0rc2) (2025.11.12)
Analyze time-series fluorescence data from PURE experiments.
Setup
%load_ext autoreload
%autoreload 2

import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

# Import the cdk platereader module
from cdk.analysis.cytosol import platereader as pr

# Set up plotting
pr.plot_setup()
import osLoad Data
labcraft_platemap = pd.read_csv("data/concentration_key_old.csv")
labcraft_platemap = labcraft_platemap.rename(columns={'Well ID': 'Well'})
labcraft_platemap = labcraft_platemap.set_index("Well")

samples = pd.read_csv("data/samples_titration_LOCK.csv", index_col="Well")
samples["Type"] = "Sample"labcraft_platemap.index.unique()Index(['F9', 'F10', 'F11', 'F12', 'F13', 'F14', 'F15', 'G9', 'G10', 'G11',
'G12', 'G13', 'G14', 'G15', 'H9', 'H10', 'H11', 'H12', 'H13', 'H14',
'H15', 'I9', 'I10', 'I11', 'I12', 'I13', 'I14', 'I15', 'J9', 'J10',
'J11', 'J12', 'J13', 'J14', 'J15'],
dtype='object', name='Well')
labcraft_platemap.columnsIndex(['[Amino Acids]_mM', '[ATP]_mM', '[Creatine phosphate]_mM', '[GTP]_mM',
'[Magnesium acetate]_mM', '[Potassium glutamate]_mM', '[tRNA]_ug/uL',
'Water_--'],
dtype='object')# samples = samples.reset_index()
samples.head()Loading...
import re

# Generic rename: labcraft format "[Name]_unit" or "Name_unit" → "[Name] (unit)"
def _rename_labcraft_col(col):
    m = re.match(r'^(.+)_([^_]+)$', col)
    if m:
        name, unit = m.group(1), m.group(2)
        if unit != '--':
            return f"{name} ({unit})"
    return col

labcraft_platemap = labcraft_platemap.rename(columns=_rename_labcraft_col)

# --- Add base master mix contributions for all matching columns ---
base_mm = pd.read_csv("data/base_master_mix_LOCK.csv", index_col="reagent")

def _col_to_reagent_key(col):
    """Convert '[Magnesium acetate] (mM)' → 'magnesium_acetate'"""
    name = re.sub(r'\s*\([^)]*\)', '', col).strip()  # remove (unit)
    name = re.sub(r'[\[\]]', '', name).strip()        # remove brackets
    return name.lower().replace(' ', '_')

for col in labcraft_platemap.select_dtypes('number').columns:
    key = _col_to_reagent_key(col)
    if key in base_mm.index:
        base_conc = base_mm.loc[key, 'base_conc']
        labcraft_platemap[col] += base_conc
        print(f"Added base_conc for '{col}': +{base_conc} {base_mm.loc[key, 'unit']}")

labcraft_platemap
Loading...
FACTOR_COLS = labcraft_platemap.columns[:-1]
FACTOR_COLS
Index(['[Amino Acids] (mM)', '[ATP] (mM)', '[Creatine phosphate] (mM)',
'[GTP] (mM)', '[Magnesium acetate] (mM)', '[Potassium glutamate] (mM)',
'[tRNA] (ug/uL)'],
dtype='object')!pwd/private/tmp/claude-501/-Users-sharonnewman-Documents-general-nucleus-skills/4a8d6065-9e0a-4e14-b326-0bffb6d3273b/scratchpad/clean/20260318-discoveryplate-aria-r1
# Overwrite common concentration columns in samples with labcraft_platemap values
# Use .update() so only matching well_ids are overwritten (no NaNs for missing wells)
common_cols = labcraft_platemap.columns.intersection(samples.columns).tolist()
samples.update(labcraft_platemap[common_cols])
print(f"Updated {len(common_cols)} columns in samples from labcraft_platemap: {common_cols}")
samples.head()
Updated 7 columns in samples from labcraft_platemap: ['[Amino Acids] (mM)', '[ATP] (mM)', '[Creatine phosphate] (mM)', '[GTP] (mM)', '[Magnesium acetate] (mM)', '[Potassium glutamate] (mM)', '[tRNA] (ug/uL)']
Loading...
# Add standard wells not in DOE samples
standards = pd.DataFrame([
    {"well_id": "K9", "Type": "Standard", "Name": "Standard"},
    {"well_id": "K10", "Type": "Standard", "Name": "Standard"},
     {"well_id": "K11", "Type": "Standard", "Name": "Standard"},
]).set_index("well_id")
samples = pd.concat([samples, standards])
samples["Well"] = samples.index

samples.to_csv("data/samples_final.csv")
samples.Well.unique()array(['J12', 'G9', 'J15', 'I11', 'I9', 'J9', 'H13', 'G12', 'H11', 'I14',
'F9', 'F12', 'I10', 'H12', 'G10', 'H15', 'J11', 'F14', 'H9', 'I15',
'I12', 'J14', 'J13', 'H10', 'H14', 'I13', 'F11', 'G13', 'F15',
'F10', 'G15', 'G14', 'J10', 'F13', 'G11', 'K9', 'K10', 'K11'],
dtype=object)# Specify file paths
data_file = "data/20260319-120157-cytation5-pure-timecourse-gfp-biotek-cdk.txt"
platemap_file = "data/samples_final.csv"
# Load data
data, platemap = pr.load_platereader_data(
data_file=data_file,
platemap_file=platemap_file,
platereader="biotek-cdk" # Options: "cytation", "envision", "biotek-cdk"
)
# Checkout first few rows
data.head()
# data["conditions"] = data.groupby(factors).ngroup()
# data["Name"] = data["conditions"]
# data = data[~data["Column"].isin([19])]Loading...
data.to_csv("samples_final_with_data.csv")Plot Raw Curves
g = pr.plot_curves(data=data, hue="Well")#[data.Type == "Sample"]) #, hue="conditions")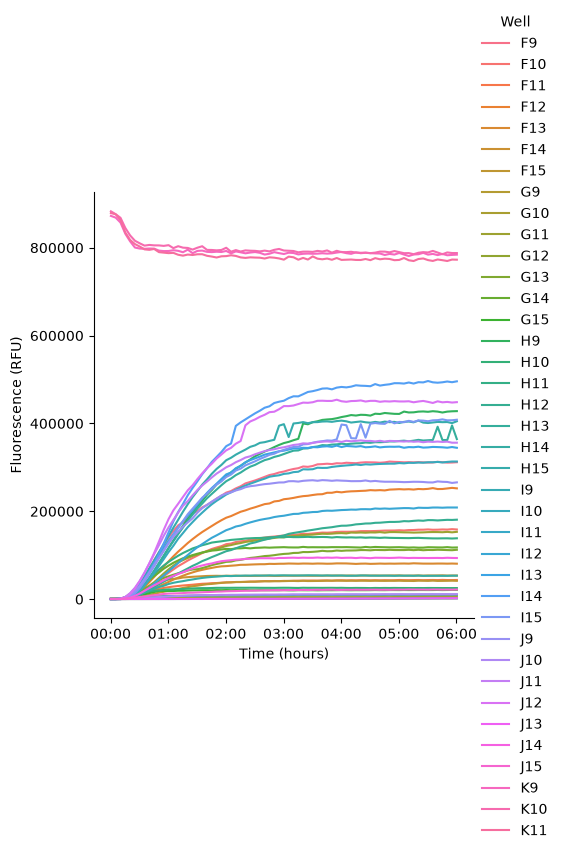
data.Name.unique()array(['11', '30', '27', '12', '34', '18', '29', '2', '15', '35', '8',
'28', '32', '31', '19', '24', '9', '14', '7', '25', '16', '5',
'13', '4', '21', '26', '10', '20', '6', '33', '17', '1', '23',
'22', '3', 'Standard'], dtype=object)dataLoading...
Normalize Data
data = pr.normalize_data_to_controls(data, ctrl_name = 'Standard')Data Normalized to Standard in col data_normalized. The active column for subsequent operations is: data_normalized
Now replot your curves to see them normalized
g = pr.plot_curves(data=data[data.Type == "Sample"])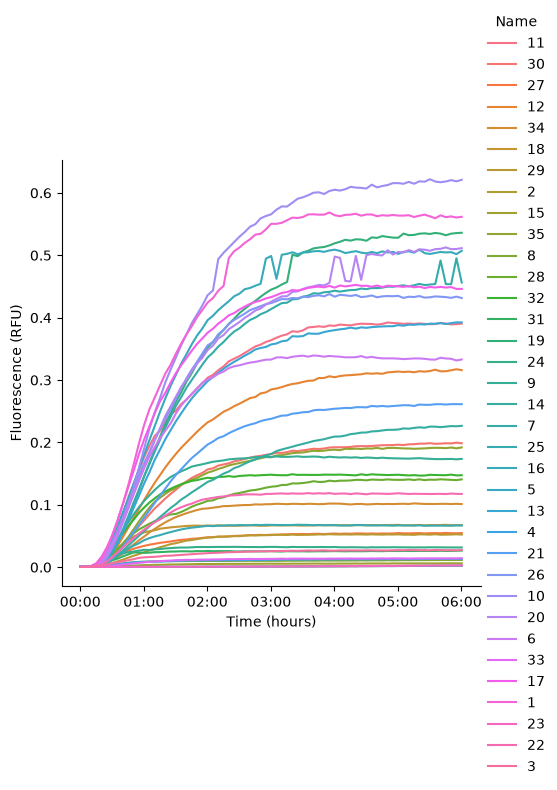
Kinetic Analysis
Metrics extracted:
Vmax (
Velocity Max): Maximum rate of fluorescence increase (slope at inflection point)Lag time: Time to reach the exponential phase
Steady-state: Final fluorescence level and time to reach 95% of asymptote
Drift: Rate of signal decay or increase after steady-state
R²: Goodness of fit
data.columnsIndex(['Time', 'Well', 'Data', 'Row', 'Column', 'Read', 'Plate', 'Clock Time',
'Name', '[DNA] (nM)', '[PMix] (mg/mL)', '[Ribosome] (uM)',
'[Magnesium acetate] (mM)', '[Creatine phosphate] (mM)',
'[Potassium glutamate] (mM)', '[ATP] (mM)', '[GTP] (mM)',
'[Amino Acids] (mM)', '[tRNA] (ug/uL)', 'hepes mM', 'ppk uM',
'polyphosphate mM', 'ctp mM', 'utp mM', 'tcep mM', 'folinic_acid mM',
'spermidine mM', 'rnas_inh U/ml',
'[Magnesium acetate] (mM) conc_to_add',
'[Magnesium acetate] (mM) vol_to_pipette_ul',
'[Creatine phosphate] (mM) conc_to_add',
'[Creatine phosphate] (mM) vol_to_pipette_ul',
'[Potassium glutamate] (mM) conc_to_add',
'[Potassium glutamate] (mM) vol_to_pipette_ul',
'[ATP] (mM) conc_to_add', '[ATP] (mM) vol_to_pipette_ul',
'[GTP] (mM) conc_to_add', '[GTP] (mM) vol_to_pipette_ul',
'[Amino Acids] (mM) conc_to_add',
'[Amino Acids] (mM) vol_to_pipette_ul', '[tRNA] (ug/uL) conc_to_add',
'[tRNA] (ug/uL) vol_to_pipette_ul', 'base_master_mix_vol_to_add_ul',
'total_titration_vol_to_add_ul', 'buffer_vol_to_add_ul',
'total_vol_check_ul', 'Type', 'ctrl_ints', 'data_normalized'],
dtype='object')# Perform kinetic analysis using sigmoid_drift model
kinetics = pr.kinetic_analysis(
data=data,
group_by=['Well', *FACTOR_COLS], # Group by experimental condition
)
# kinetics = kinetics.reset_index()
kinetics.head()Loading...
data.head()Loading...
Visualize Fits on Individual Wells
# Plot kinetic fits
# g = pr.plot_kinetics(data,  group_by=['Well', *FACTOR_COLS])
Summary Plots
# pr.plot_summary(data)responses = ["steady_state", "vmax", "lag_time_min"]
kin = kinetics.reset_index()
kin.columns = [
"_".join([str(x).replace(" ", "_") for x in col if x])
for col in kin.columns
]
factors = [str(x).replace(" ", "_") for x in FACTOR_COLS]
kin.head()Loading...
kin.columnsIndex(['Well', '[Amino_Acids]_(mM)', '[ATP]_(mM)', '[Creatine_phosphate]_(mM)',
'[GTP]_(mM)', '[Magnesium_acetate]_(mM)', '[Potassium_glutamate]_(mM)',
'[tRNA]_(ug/uL)', 'Velocity_Time', 'Velocity_data_normalized',
'Velocity_Max', 'Lag_Time', 'Lag_data_normalized', 'Steady_State_Time',
'Steady_State_data_normalized', 'Fit_params', 'Fit_R^2', 'Fit_drift',
'Fit_good_fit'],
dtype='object')from plate_qc import (
qc_summary, plot_replicate_agreement,
plot_plate_heatmap, plot_qc_overview,
)
responses = ['Steady_State_data_normalized', 'Velocity_Max']clean, failed = qc_summary(kin, factors, responses)==================================================
DOE QC Summary
==================================================
Total wells: 35
Good fits: 32 (91.4%)
Failed fits: 3 (8.6%)
R² < 0: 0
0 ≤ R² < 0.9: 2
Response metrics (good fits only):
Steady_State_data_normalized min=0.0029 median=0.1706 max=0.5949
Velocity_Max min=0.0009 median=0.1061 max=0.2972
Factor ranges for FAILED wells:
[Amino_Acids]_(mM) [0.259 – 0.290]
[ATP]_(mM) [2.400 – 3.000]
[Creatine_phosphate]_(mM) [44.000 – 60.000]
[GTP]_(mM) [1.400 – 3.000]
[Magnesium_acetate]_(mM) [1.000 – 6.000]
[Potassium_glutamate]_(mM) [40.000 – 55.000]
[tRNA]_(ug/uL) [2.345 – 3.990]
==================================================
kin.head()Loading...
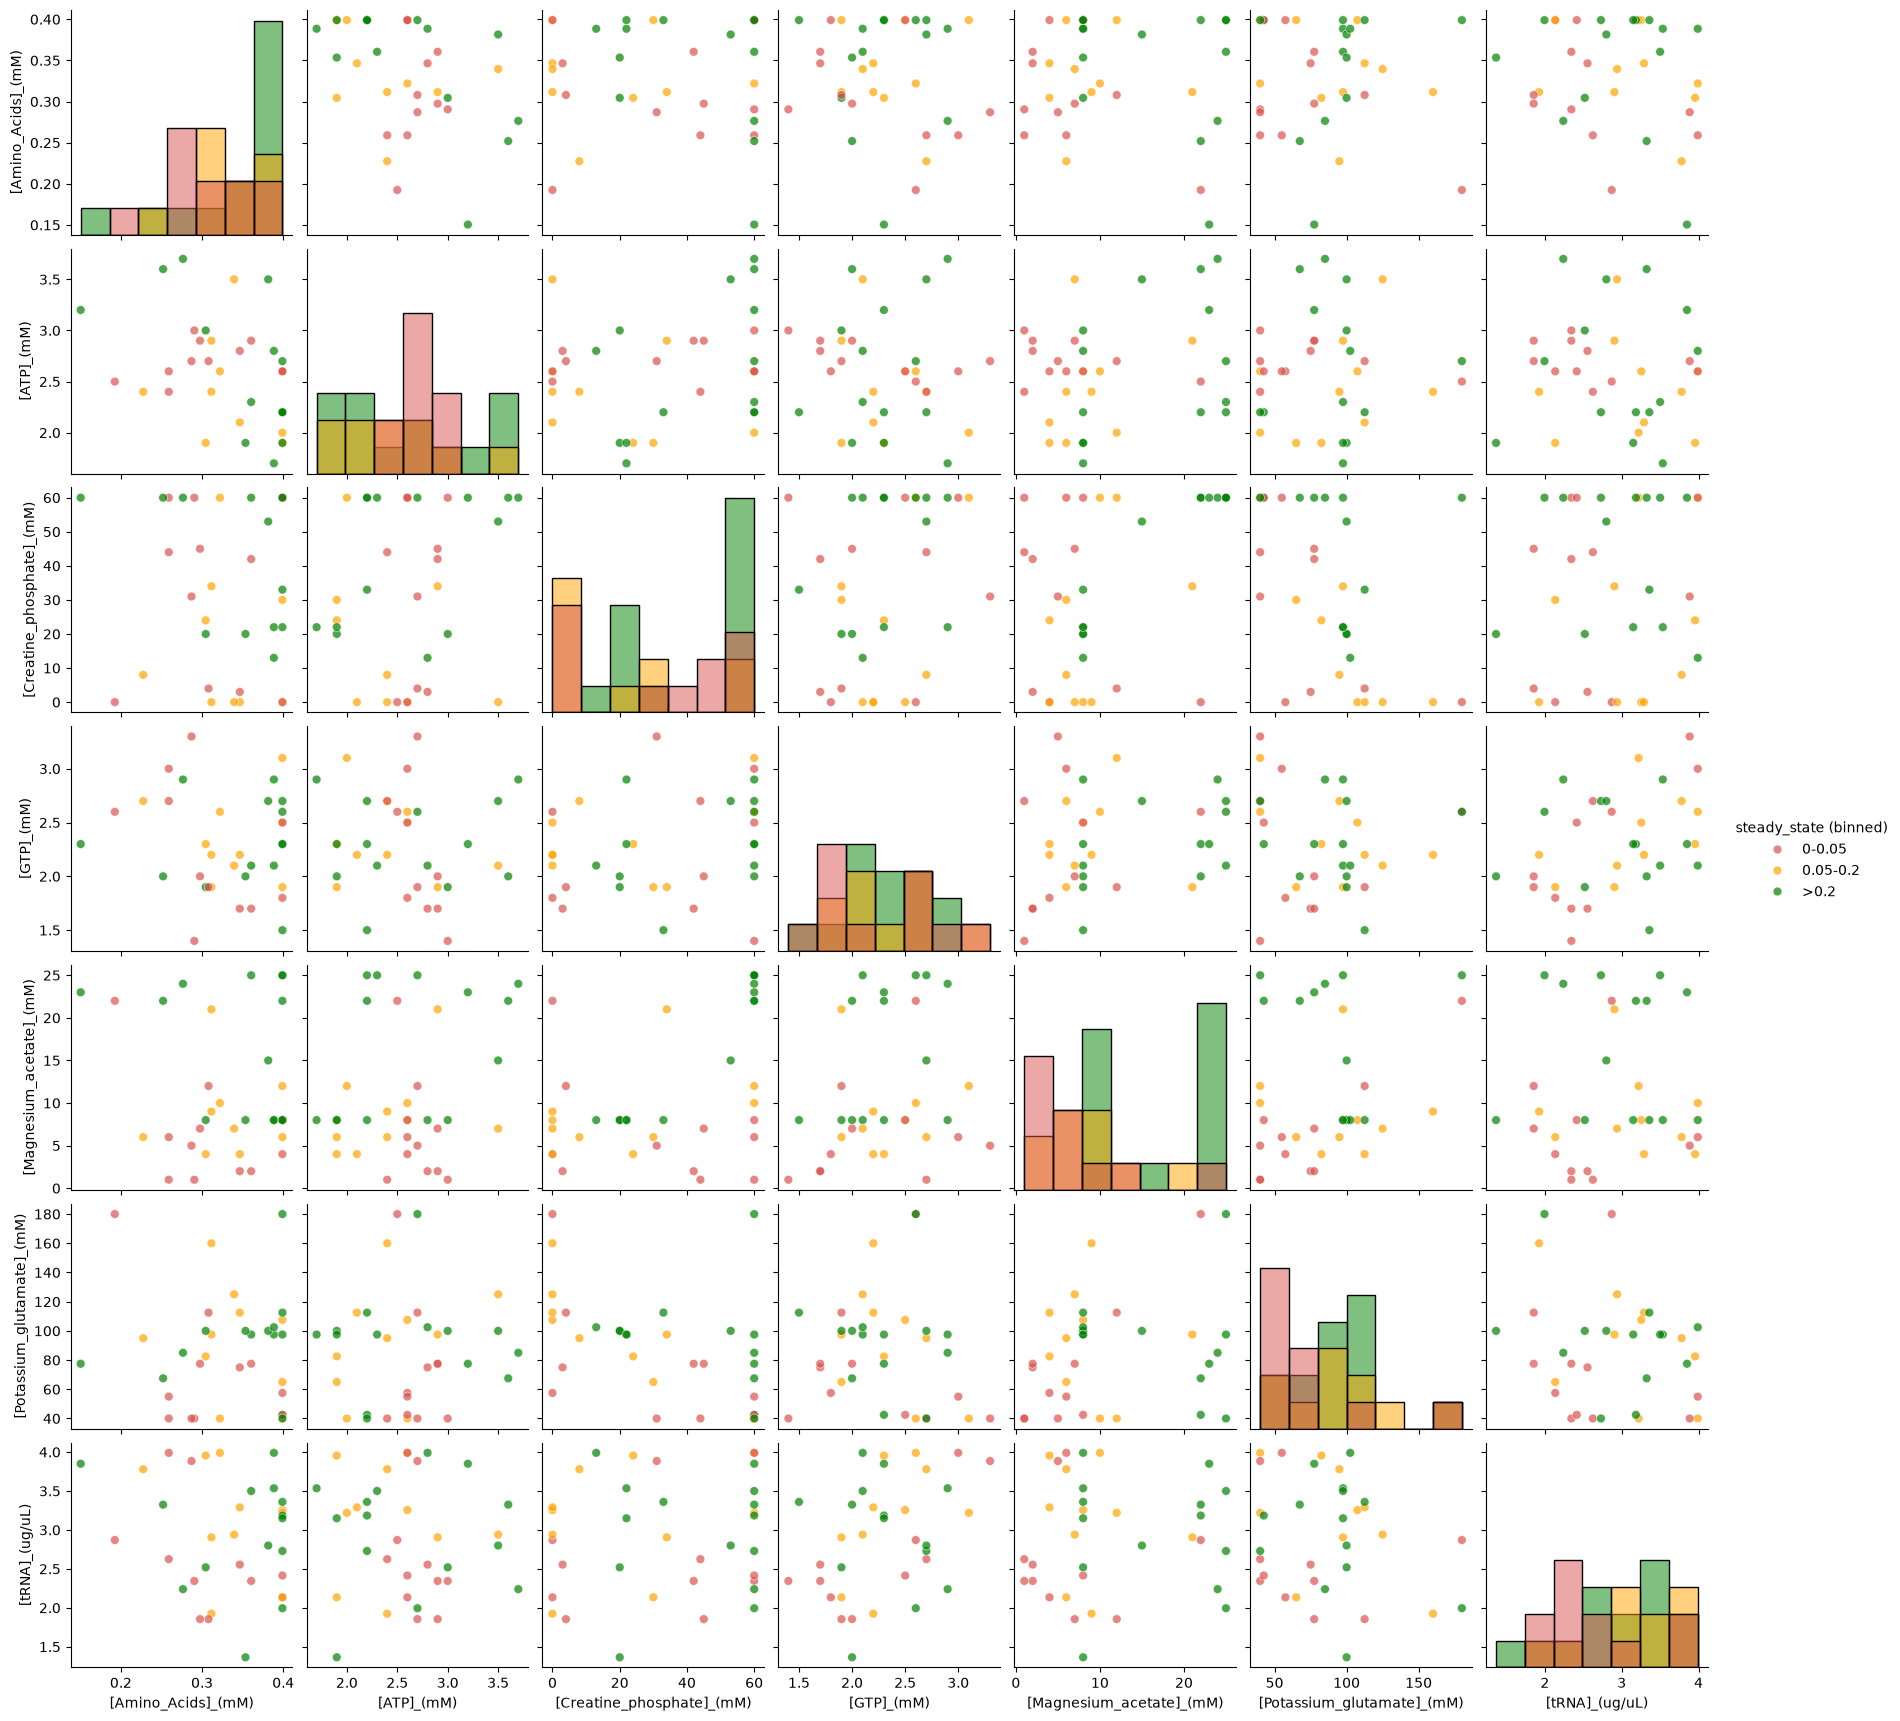
import seaborn as sns
kin['steady_state (binned)'] = pd.cut(
  kin['Steady_State_data_normalized'],
  bins=[0, 0.05, 0.2, 1.0],
  labels=['0-0.05', '0.05-0.2', '>0.2']
)
# val = "Steady_State_data_normalized"
val = 'steady_state (binned)'
g = sns.pairplot(
  kin[factors + [val]],
  vars=factors,
  hue=val,
  palette={'0-0.05': '#d9534f', '0.05-0.2': 'orange', '>0.2': 'green'},
  # palette={'0-0.05': '#d9534f', '0.05-0.2': 'orange', '>0.2': 'blue'},
  plot_kws={'alpha': 0.7, 's': 40},
  diag_kind='hist',
)